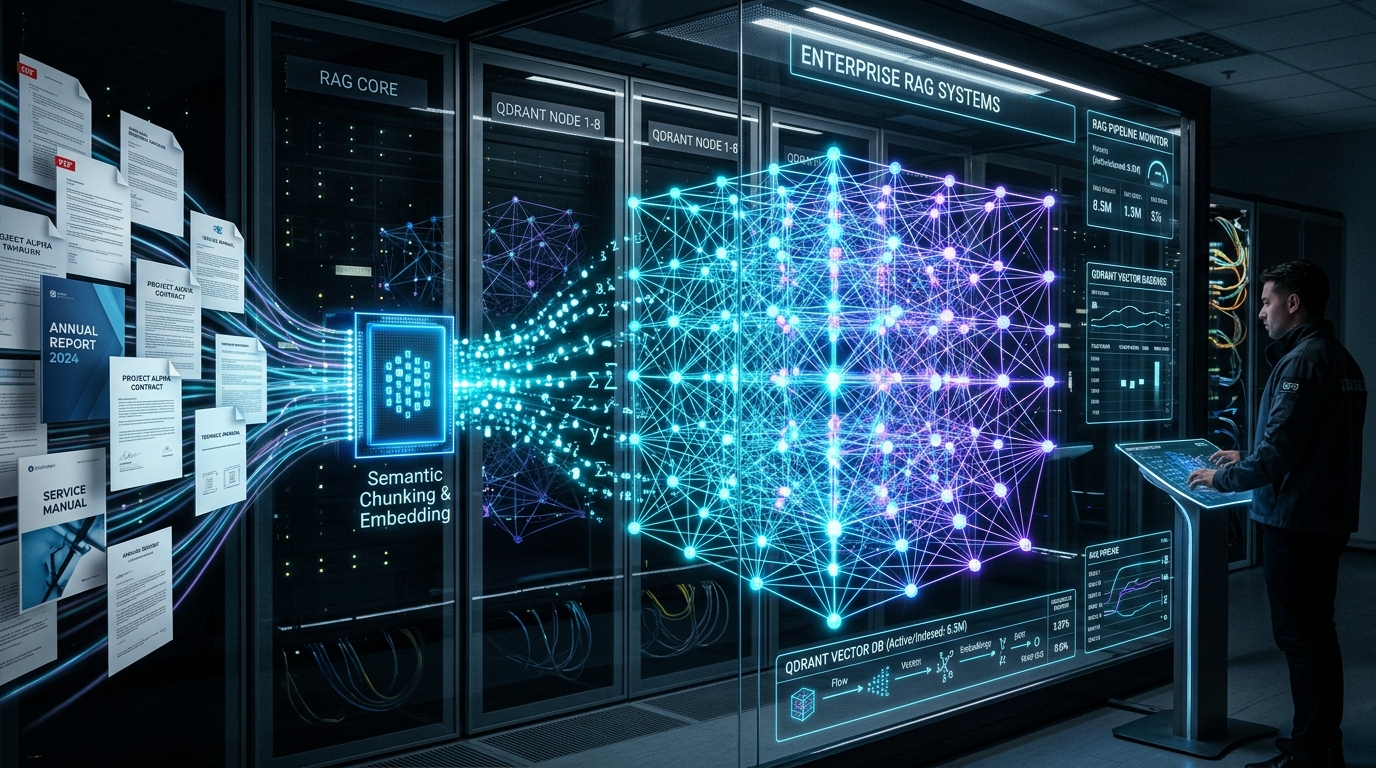
O componente mais crítico — e frequentemente negligenciado — de um pipeline de RAG (Retrieval-Augmented Generation) não é o modelo gerador final, mas sim o modelo de embedding responsável por converter os textos em vetores.
Muitas implantações amadoras utilizam modelos de embedding treinados quase exclusivamente com textos em inglês. Ao processar documentos em português, esses modelos confundem gírias corporativas, terminologia do direito brasileiro (como 'tutela de urgência' ou 'embargos') e nomenclaturas tributárias (como ICMS, PIS/COFINS).
A SpeedyNet homologa e afina modelos multilíngues de última geração, como o BGE-M3 (BAAI General Embedding) e modelos especializados nacionais avaliados no benchmark MTEB (Massive Text Embedding Benchmark).
Nossos testes comprovam que a arquitetura híbrida (Dense Retrieval para sentido semântico + Sparse BM25 para termos exatos como códigos de peças ou números de CNPJ) atinge precisão superior a 94% na recuperação do contexto correto.
Essa engenharia refinada assegura que a IA responda exatamente o que está nos manuais da sua empresa, com precisão técnica irretocável.