Quando empresas decidem que a Inteligência Artificial precisa 'conhecer os manuais, normas técnicas e políticas internas', o primeiro impulso de equipes inexperientes é tentar fazer Fine-Tuning (ajuste fino) de um modelo aberto.
No entanto, o Fine-Tuning tem falhas fatais para uso documental: é caríssimo em termos de poder computacional de GPU, não permite atualizar um parágrafo de contrato sem reprocessar tudo e não garante que o modelo cite a página exata da resposta.
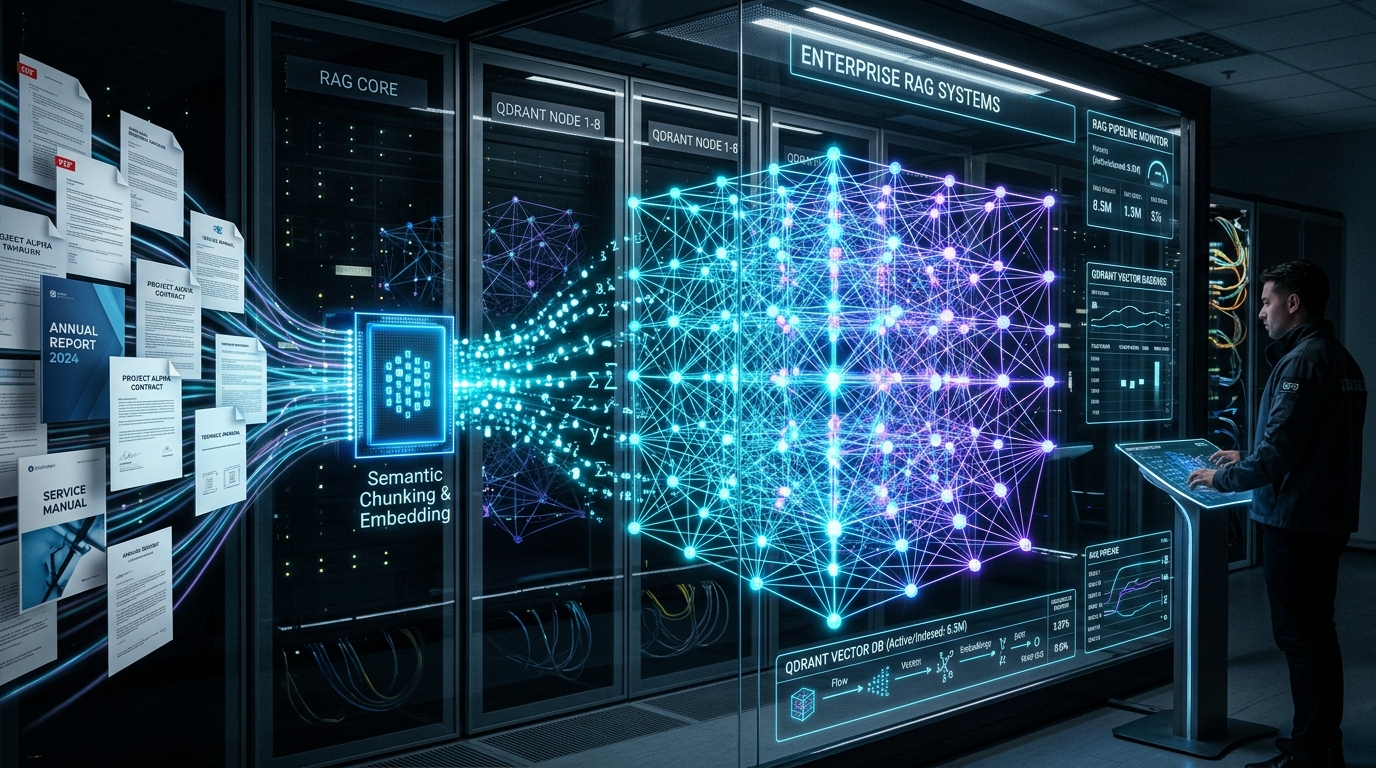
A arquitetura moderna consagrada é o RAG (Retrieval-Augmented Generation): os documentos da empresa (PDFs, planilhas, contratos, e-mails e wikis) são divididos em fragmentos semânticos (chunks) e transformados em vetores matemáticos armazenados no banco vetorial Qdrant.
Quando o colaborador faz uma pergunta, o Qdrant realiza busca semântica em frações de milissegundo, recupera os trechos mais relevantes do arquivo original e os injeta no prompt do modelo de IA local.
O resultado é duplo: respostas precisas, contextualizadas e sem alucinações, acompanhadas de links clicáveis que apontam exatamente para a página do documento original utilizado como fonte.