Rodar um modelo aberto no notebook de um engenheiro para testes é simples. Colocar esse mesmo modelo para responder simultaneamente a 200 colaboradores em um call center ou escritório exige engenharia avançada de sistemas.
O principal gargalo na inferência de LLMs é a memória de vídeo da placa gráfica (VRAM): modelos de 70 bilhões de parâmetros exigem técnicas de quantização (como FP8, AWQ ou GGUF de 4 bits) para caberem em placas profissionais de 24GB ou 48GB de VRAM.
A SpeedyNet arquiteta ambientes de alta concorrência utilizando o vLLM, motor de inferência que implementa PagedAttention: essa tecnologia gerencia a memória da GPU da mesma forma que os sistemas operacionais modernos gerenciam memória virtual, reduzindo o desperdício de VRAM a quase zero.
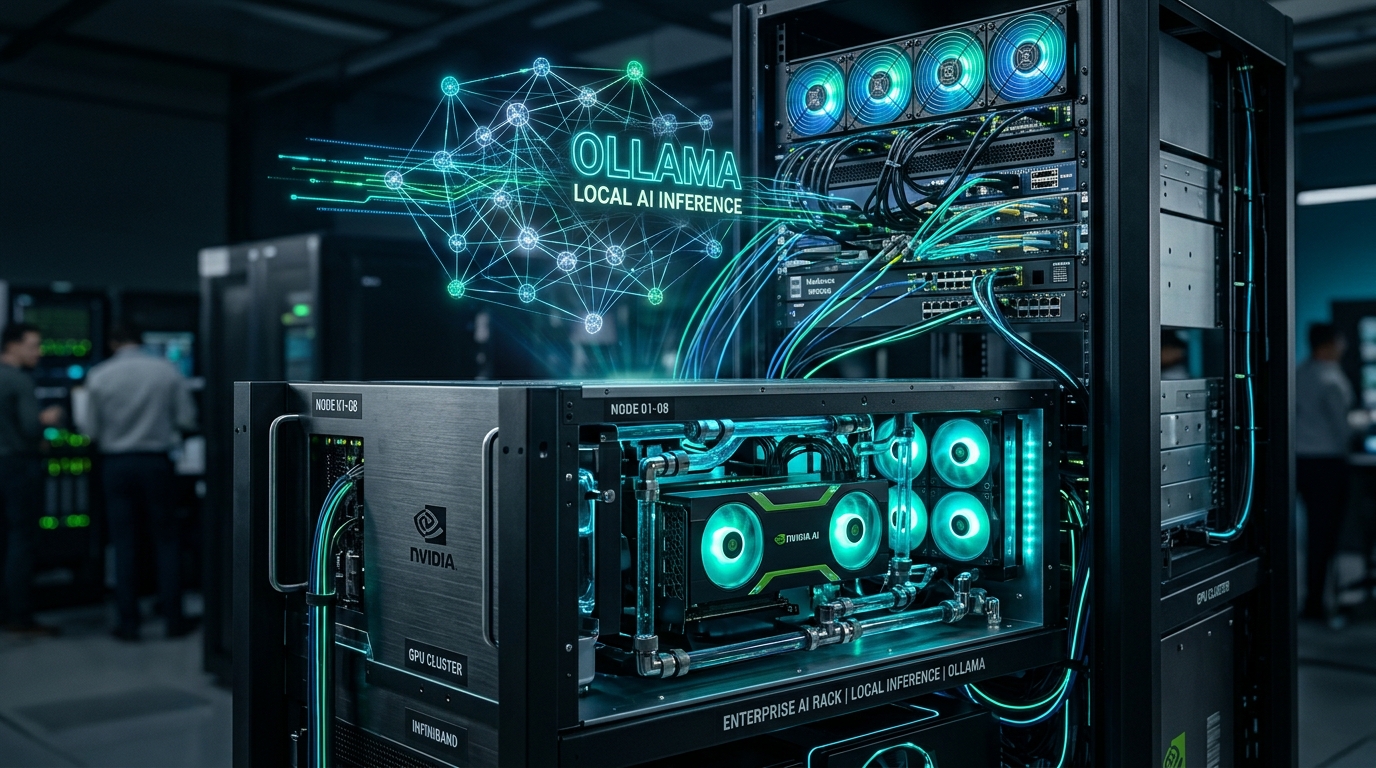
Para ambientes que demandam múltiplos modelos especializados (um modelo para codificação, outro para redação jurídica e outro para análise de dados), configuramos o Ollama com suporte a troca dinâmica de modelos e endpoints compatíveis com a API da OpenAI.
Toda a infraestrutura é monitorada por sensores dedicados no Zabbix acompanhando temperatura das GPUs, utilização de núcleos CUDA e latência de geração de tokens.