A primeira onda da Inteligência Artificial corporativa levou empresas a experimentar APIs públicas de grandes modelos de linguagem. No entanto, à medida que a adoção se expande para rotinas diárias de centenas de colaboradores, duas dores críticas emergem: o custo por token e o sigilo de dados.
Pagar por milhão de tokens consumidos em consultas a bases de contratos e faturas gera faturas mensais imprevisíveis e dolarizadas que crescem exponencialmente.
Mais grave ainda é o risco jurídico: ao colar balanços financeiros, minutas contratuais de fusões e códigos-fonte proprietários em plataformas de nuvem pública, a empresa renuncia ao controle físico de seus dados mais valiosos.
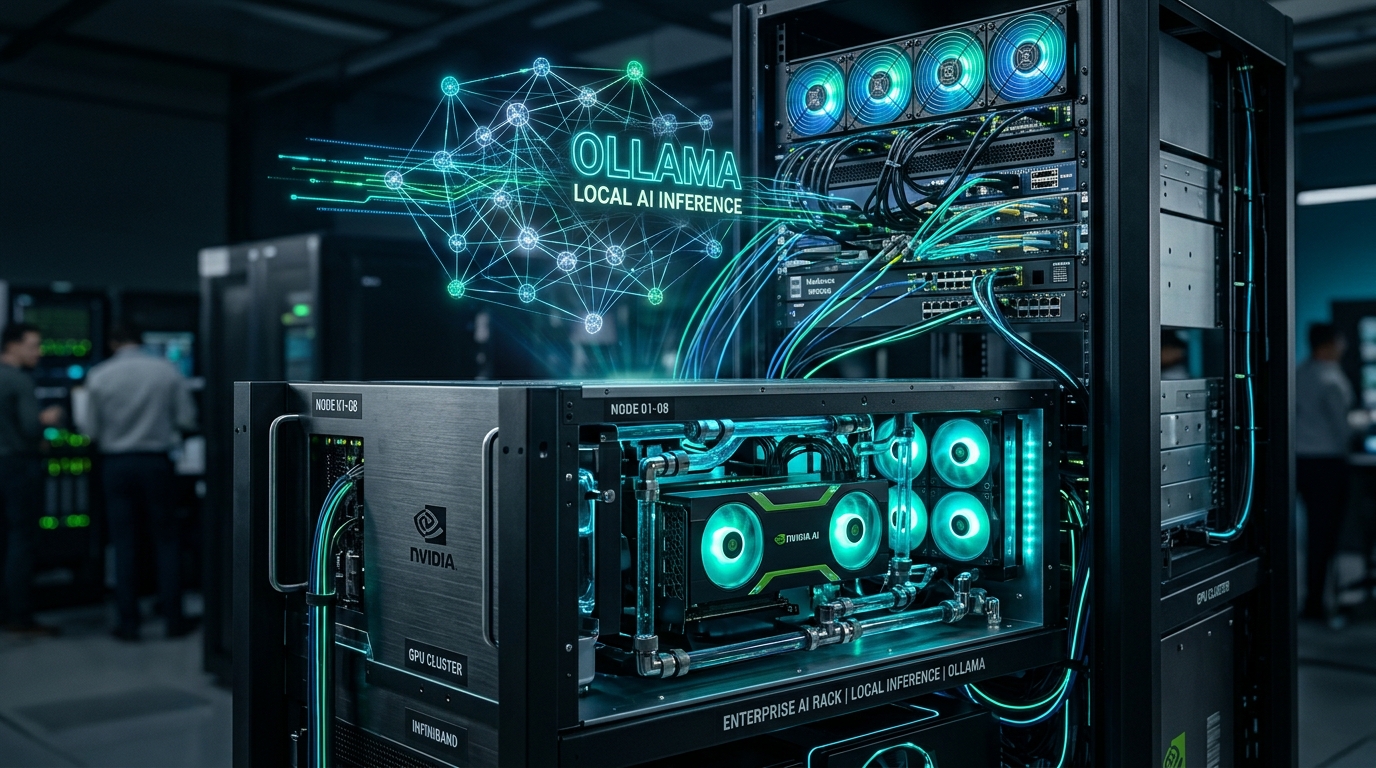
A resposta técnica é a Inteligência Artificial On-Premises: a SpeedyNet dimensiona e instala servidores de alta densidade equipados com GPUs NVIDIA profissionais (RTX 4090, RTX 6000 Ada ou A100), orquestrados por runtimes locais (Ollama e vLLM).
Modelos open-weight de última geração (como Llama 3.3 70B, Qwen 2.5 e DeepSeek) rodam com latência inferior a 15ms por token diretamente na sua rede local, sem depender de internet externa e com conformidade total à LGPD.