Projetar um servidor para Inteligência Artificial corporativa exige uma mudança radical de mentalidade técnica em comparação aos servidores de bancos de dados ou arquivos tradicionais.
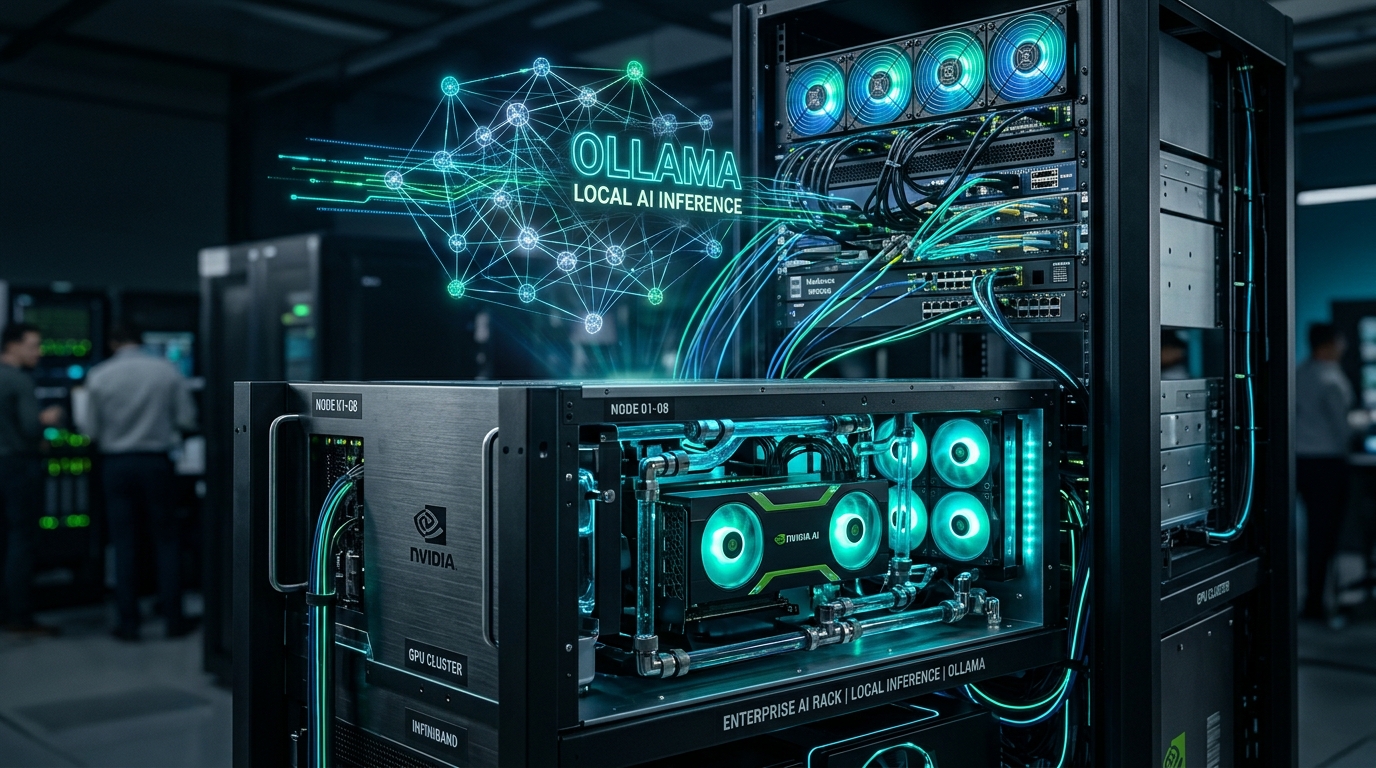
Em servidores convencionais, o foco é capacidade de CPU x86 e memória RAM DDR5. Na inferência de modelos de linguagem (LLMs), a CPU atua apenas como coordenadora: todo o processamento de multiplicação de matrizes ocorre nos núcleos Tensor das GPUs.
Para empresas que desejam rodar modelos de 8B a 14B de parâmetros (como Llama 3 8B ou Qwen 2.5 14B), placas como a NVIDIA RTX 4090 (24GB de VRAM) entregam excelente velocidade com custo acessível.
Para modelos maiores de 70B de parâmetros necessários em tarefas jurídicas e analíticas complexas, são necessárias placas corporativas como a NVIDIA RTX 6000 Ada (48GB VRAM) ou configurações multi-GPU interconectadas.
A SpeedyNet dimensiona o hardware considerando não apenas o poder de computação, mas também o consumo elétrico, dissipação térmica em racks corporativos e fontes redundantes para garantir operação ininterrupta 24/7.